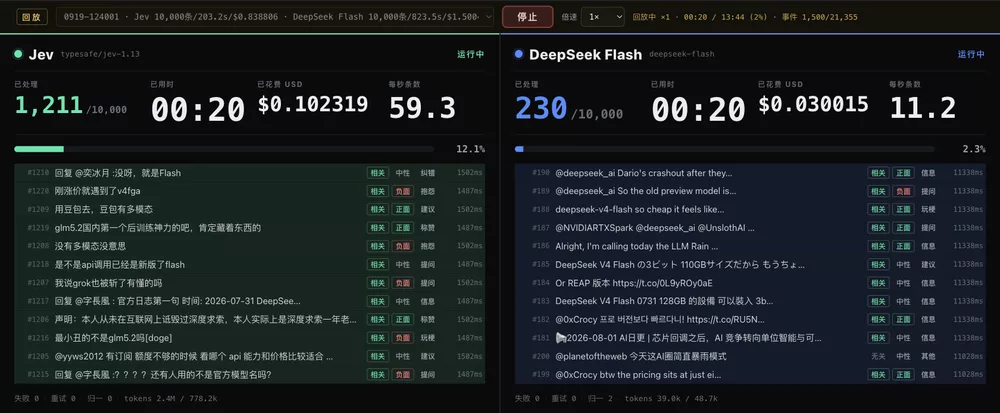
定位:同一批评论,两个模型正面碰
仓库开篇一句话就是产品定义:同一批评论,对比两个模型的速度、费用和标注结果。它支持 CSV 与 Excel 导入、实时对决、录像回放和离线报告,默认的一对是 Jev 与另一个国产代码模型,也可以配置成其他兼容主流协议的聊天模型。整个工具跑在你本地:需要 Node.js 22 或以上(也提供容器运行方式),结果落在自己的运行目录里,许可为 MIT、核验时约 92 星标。项目还配了一个中文原理解释站,标题很直接——它不生成文字,它返回判断。
深度介绍
仓库开篇一句话就是产品定义:同一批评论,对比两个模型的速度、费用和标注结果。它支持 CSV 与 Excel 导入、实时对决、录像回放和离线报告,默认的一对是 Jev 与另一个国产代码模型,也可以配置成其他兼容主流协议的聊天模型。整个工具跑在你本地:需要 Node.js 22 或以上(也提供容器运行方式),结果落在自己的运行目录里,许可为 MIT、核验时约 92 星标。项目还配了一个中文原理解释站,标题很直接——它不生成文字,它返回判断。
使用路径是四步。导入:上传 CSV 或 Excel,也可以用自带的合成评论(默认 20 条,超过 30 条会要求确认)。对决:填入两个模型的密钥、点开始,两边对同一批数据各自跑一遍。回放:每次运行的现场都会落盘到以运行编号命名的目录里,随时可以原速回放——关键的一点是回放阶段不调用模型,想反复看当时的对比不需要再花一分钱。报告:跑完用一条命令就能离线生成两侧的 HTML 报告,生成过程也不需要任何密钥。
仓库里落档了一次一万条真实评论的对照:复核方是一个第三方前沿模型,对每条只看原文与原标题独立标注,再对照两侧结果,另外随机抽 400 条复标。结果一目了然——速度上 Jev 侧 203.2 秒对 823.5 秒,费用 0.84 美元对 1.50 美元(后者为估算),准确率方面 Jev 在相关性、情感、意图三项上略低,三项同时正确率为 62.69% 对 67.26%。但 README 把口径写在最前面:这是 AI 参考下的复核结果、不是人工金标准;采用允许合理歧义的口径,若严格只认首选答案,两项三项全对率是 50.58% 与 55.45%;且所有数字仅代表本次数据和配置。
这是它和一次性跑分最大的区别:三样东西都挂了链接——完整准确率报告、逐条核查表(一份 CSV)、原始数据与两侧标签。也就是说任何人可以顺着任何一个百分比往下钻,看到具体是哪几条样本产生了分歧,而不是只能接受一个总数。配套还有标签契约文档,约定两侧返回的字段怎么对齐;仓库自带测试,跑一次就能确认环境没装歪。演示用的评论本身版权归原作者与平台,README 也把这个边界写明了。
项目站用整整一节回答「为什么判断类任务不该拿会聊天的模型做」,五个坑列得很具体:一,你拿到的是文字而不是判断,还得从自由文本里剥出结构,模型哪天多寒暄一句解析就崩;二,提示词与解析是两层契约,任一层漂移就静默失败——它把拼错的字段直接写进你的库还带进各种大小写变体;三,规则写进系统提示词,正好放在攻击者最熟练的位置;四,每次判断都是一次完整生成,只想要一个 0 到 2 的分数,却可能生成几百个 token 的推理过程,慢且贵;五,模型自报的置信度从未与真实结果对齐过。
原理解释站把表达能力故意限制成三种形状,并给出了选择准则:从一组定义好的选项里选一个、答案是整片概率分布的,用 Choice;沿一条有顺序的维度打分、答案是归一化位置的,用 Score;判断一个条件是否成立、答案是一个概率的,用 Noul(没有单独的置信度)。它还给了一条很实用的提醒:多个标签可能同时成立时应当用多个 Noul,而不是塞进一个 Choice——Choice 的概率互相竞争、会此消彼长。形状固定返回值才永远可解析,选择有限概率才校准得出来。
站点把两者的分工讲得很清楚:概率告诉你「是什么」,置信度告诉你「敢不敢动」——把分布压成 0 到 1 的数,就能不写数学直接做阈值判断。原则是 confidence 低于 0.5 兜底接住模型自己都说不好的,往上则每个动作按后果分设阈值:只读查询可以不设门槛,不可逆的转账要高门槛,而阈值没有标准答案、必须用你自己的数据跑出来。它还澄清了在智能体里的位置:Jev 不规划、不写代码、不调工具,只在循环的岔路口用约百毫秒给一个可信的是或否。
站点末尾给了一个可拖动的规模估算器,背后是两条叠加的原因。第一,单次判断是几十到几百毫秒,不是秒级。第二更关键:同一份文本上的多个问题合并进一次请求、文本只发一遍——官方一个十三问的合规案例正是靠这个拿到一个数量级的成本与时间差。估算器让你输入条目数、每条平均 token、每条要问几个问题和并发上限,直接换算输入总量、总成本与吞吐下限。一万条评论的实测之所以跑得飞快,根子就在这两个数字上。
产品特点
不是各跑各的再拼数字:两边处理同一批评论,速度、费用与三类标注准确率并排放在一张表里。一万条评论的落档实测还附了完整报告、逐条核查表与原始标签,任何百分比都能钻回样本。
每次运行的现场都落盘保存,回放时不再调用任何接口。想慢慢看当时两边的差异、或者给同事演示,都不用重新花钱跑一遍——这让实测从一次性动作变成可归档的证据。
报告一条命令生成、不需要密钥,正文默认是事实草稿;准确率口径把「AI 参考复核、非人工金标准」「两套歧义口径」「仅代表本次数据与配置」三条都写在开头。社区实测做到这个坦白程度,数字反而更可信。
工具之外还有一整站中文讲解:从「为什么判断类任务不该用会聊天的模型」的五个坑,到三种原语怎么选、阈值怎么按后果分设,再到合并提问的规模计算器。先想明白再动手,比先跑分再争论有用。
最近动态
仓库在九月中旬完成并归档了一次一万条真实评论的对照:第三方前沿模型对每条只看原文与原标题独立标注、再对照两侧结果,另随机抽 400 条复标。速度与费用差距明确,准确率三项 Jev 略低但差距不大;完整准确率报告、逐条核查表与原始数据及两侧标签均已挂链可查,口径与免责说明写在最前面。
核验时代码仓库、项目原理解释站、使用指南、实测报告与数据页均可正常访问;仓库约 92 星标、MIT 许可(署名 2026 年维护者)、主分支为默认分支。启动要求 Node.js 22 及以上或容器运行,产物与回放都保存在本地运行目录中。
Jev Arena 是一个本地运行的模型实测工具,仓库开篇一句话定义了它:同一批评论,对比两个模型的速度、费用和标注结果。功能覆盖四步工作流——CSV 与 Excel 导入(默认 20 条合成评论,超过 30 条需确认)、填入两把密钥后实时对决、录像回放(回放不调用模型)、以及一条命令离线生成两侧 HTML 报告(同样不需要密钥)。工具需 Node.js 22 或以上、也提供容器方式,结果保存在本地运行编号目录里,MIT 许可、核验时约 92 星标;默认的一对是 Jev 与另一个国产模型,也可配置其他兼容主流协议的模型。 仓库落档的一万条评论实测是它的核心内容:由第三方前沿模型对每条只看原文与标题独立标注后对照两侧、另随机抽 400 条复标。结果是速度 203.2 秒对 823.5 秒、费用 0.84 美元对 1.50 美元(后者估算),准确率三项(相关性、情感、意图)Jev 略低,三项同时正确率 62.69% 对 67.26%。口径声明写在最前面——AI 参考下的复核结果而非人工金标准、采用允许合理歧义的口径、严格只认首选时两项为 50.58% 与 55.45%、所有数字仅代表本次数据与配置。配套三样可复查材料:完整准确率报告、逐条核查 CSV、原始数据与两侧标签;另有标签契约与仓库自带测试。 项目还配了一个中文原理解释站,回答「为什么判断类任务不该拿会聊天的模型做」,列了五个坑:文字而非判断带来的解析脆弱、提示词与解析两层契约的静默失败、系统提示词是攻击面、每次判断都是一次完整生成(想要一个 0–2 分却生成数百 token)、以及模型自报置信度从未校准(站点给出说 0.9 的批次实际对 63%、校准过的对 89% 的对比)。站点随后给出三种原语的选法(多标签并存用多个 Noul 而非一个 Choice)、阈值原则(低于 0.5 兜底、按动作后果分设、须用自己的数据跑)、以及它在智能体里的位置(不规划不调工具、只在岔路口百毫秒给答案),最后用规模计算器解释合并提问带来的量级优势。 边界也写清楚:这是社区工具与社区讲解站,不是官方产品;实测数字受数据与配置影响、准确率以 AI 复核为口径;真正的选型结论仍应回到官方文档与你自己的数据上验证。
核验信息
本页事实来自:仓库 README(产品定义与四类功能、导入与确认规则与两把密钥、本地运行目录、回放不调用模型、离线报告与事实草稿、一万条评论实测的复核方法与耗时与费用与准确率及两项全对率与三条口径声明、三个可查链接、Node 22 或容器启动、标签契约与测试、MIT 许可与演示评论版权边界)、仓库与子文档页面(使用指南、实测报告、数据与标签说明、许可,核验时均在线、约 92 星标、主分支与 2026 年署名)、项目原理解释站(返回判断而非文字的定位、五个坑的论证与校准示例、三种原语与多标签用多个 Noul 的选法、阈值原则与 0.5 兜底、智能体里的岔路口定位、延迟与合并提问与规模计算器及十三问案例的量级数字),以及所引用的 Jev 官方文档页。页内未列出复核所用第三方模型与对照模型所属平台的受限品牌名。状态核验于 2026 年 9 月 22 日。
Jev Arena介绍页面对您是否有帮助?